LA BIBLIOTECA DE LAS MÁQUINAS – Entrega II: la biblioteca que nadie puede visitar. Por Oscar Rodríguez
Las bibliotecas ya no se construyen para las personas, sino para las máquinas. Millones de libros dejan de ser leídos para convertirse en datos privados. El autor advierte sobre las corporaciones que controlan la infraestructura para procesar la memoria colectiva
LA BIBLIOTECA DE LAS MÁQUINAS
Una saga sobre memoria, cultura, inteligencia artificial y poder
ENTREGA II
LA BIBLIOTECA QUE NADIE PUEDE VISITAR
Cuando millones de libros dejan de organizarse para ser leídos por personas y comienzan a organizarse para ser procesados por máquinas
La biblioteca existe.
Eso lo sabemos.
El problema es encontrar la puerta.
Imaginemos que quisiéramos visitarla.
No para denunciarla.
No para protestar.
Solamente para entrar.
Caminar entre sus estanterías.
Buscar un libro.
Abrirlo.
Consultar el catálogo.
Preguntar quién decidió comprarlo.
Quién decidió conservarlo.
Qué otros títulos están junto a él.
Qué autores quedaron afuera.
Pero no podemos.
Porque la biblioteca que estamos buscando no fue construida para nosotros.
No tiene una puerta por donde entre un lector.
No tiene sala de lectura.
No tiene mostrador.
No tiene mesas.
Probablemente tampoco tenga aquello que durante siglos nos permitió reconocer inmediatamente una biblioteca:
estanterías.
Y sin embargo contiene millones de libros.
O, mejor dicho, millones de libros convertidos en otra cosa.
Archivos.
Datos.
Corpus.
Una memoria gigantesca almacenada detrás de servidores a los que nosotros no tenemos acceso.
En la entrega anterior seguimos a uno de esos libros.
Lo vimos llegar.
Le quitaron la encuadernación.
Cortaron el lomo.
Separaron sus páginas.
Lo escanearon.
El ejemplar desapareció.
El archivo quedó.
Pero cometimos un error.
Estábamos mirando demasiado al libro.
Esta vez tenemos que levantar la cabeza.
Porque detrás de aquella máquina había algo muchísimo más grande.
Una biblioteca creciendo en silencio.
Durante años, casi nadie fuera de la empresa hubiera tenido motivos para pensar en aquella biblioteca.
No era un edificio público.
No aparecía anunciada como una gran institución cultural.
No tenía lectores esperando su inauguración.
Pero en 2025 ocurrió algo.
Una demanda abrió una pequeña grieta.
Y por esa grieta pudimos mirar.
El caso se llamó Bartz v. Anthropic.
Entre cientos de páginas judiciales comenzó a aparecer la descripción de una infraestructura que la propia documentación denominaba una central library, una biblioteca central o área general de datos.
Anthropic había reunido allí millones de libros digitalizados.
Algunos provenían de ejemplares impresos que la empresa había comprado y escaneado destructivamente.
Otros habían llegado antes desde repositorios piratas como Books3, LibGen y PiLiMi.
Desde aquella biblioteca, los ingenieros seleccionaban conjuntos y subconjuntos de libros.
Probaban combinaciones.
Sacaban algunos.
Agregaban otros.
Construían diferentes mezclas de datos.
Después utilizaban esas selecciones para entrenar distintos modelos de lenguaje.
El objetivo era mejorar su funcionamiento.
Mejorar finalmente a Claude.
La resolución judicial describe incluso que los ingenieros podían buscar libros dentro de aquella colección y acceder a los archivos escaneados. Y señala algo todavía más interesante: determinadas obras podían permanecer en esa biblioteca aunque la empresa decidiera no utilizarlas nuevamente para entrenar un modelo.
La biblioteca tenía entonces una vida propia.
No era simplemente una bolsa de textos que entraban en una máquina y desaparecían.
Era un depósito permanente.
Una reserva.
Un recurso.
Un lugar donde conservar información para usos presentes…
o futuros.
Y aquí aparece la primera pregunta.
¿Cuándo una colección deja de ser solamente una colección y empieza a convertirse en infraestructura?
BIBLIOTECA
La palabra nos resulta familiar.
Quizás demasiado.
Cuando decimos biblioteca imaginamos acceso.
Un chico haciendo la tarea.
Una mujer buscando una novela.
Un estudiante preparando un examen.
Un jubilado leyendo el diario.
Un investigador consultando un documento.
Una bibliotecaria ayudando a encontrar algo que alguien no sabía exactamente cómo buscar.
Una biblioteca puede guardar libros.
Pero su sentido social no está solamente en guardarlos.
Está en la relación que construye entre esos libros y una comunidad.
Por eso una biblioteca cerrada durante años empieza a parecer algo incompleto.
Puede tener cien mil volúmenes.
Pero sin acceso, sin lectores, sin mediación…
algo esencial falta.
Una colección no se define solamente por lo que contiene. También por aquello que excluye
La biblioteca de Anthropic responde a otra lógica.
No fue diseñada primordialmente para satisfacer el derecho de una comunidad a acceder al conocimiento.
Fue construida para investigación y para alimentar procesos internos de una empresa de inteligencia artificial.
Eso no la convierte automáticamente en algo perverso.
Las empresas llevan siglos construyendo archivos privados.
Los laboratorios guardan documentación.
Las universidades tienen colecciones restringidas.
Los Estados mantienen información que no está abierta indiscriminadamente al público.
El simple hecho de que una biblioteca sea privada no demuestra ningún complot.
Pero tampoco significa que la diferencia sea trivial.
Porque aquí hay algo nuevo.
La escala.
Y, sobre todo, la función.
Probemos hacer un experimento.
Imaginemos a una persona que quisiera leer un millón de libros.
Supongamos que consigue terminar un libro por día.
Sin descanso.
Sin enfermarse.
Sin domingos.
Sin vacaciones.
Un millón de libros necesitarían más de dos mil setecientos años.
Y eso suponiendo una hazaña absurda:
un libro completo cada veinticuatro horas durante casi tres milenios.
Nuestra biología impone un límite.
Podemos acumular bibliotecas mucho más grandes que aquello que cualquiera de nosotros podrá leer.
Siempre fue así.
La Biblioteca Nacional contiene más materiales de los que una persona podría recorrer en una vida.
Pero una máquina modifica el problema.
No porque “lea” como nosotros.
No lo hace.
Pero puede procesar cantidades de texto que ningún individuo podría atravesar.
Y entonces la dimensión de la colección empieza a producir otra clase de poder.
Un millón de libros ya no representa solamente un millón de posibilidades de lectura.
Puede representar un conjunto de entrenamiento.
Una fuente de patrones.
Lenguaje.
Estilos.
Estructuras.
Relaciones.
Información.
El valor ya no reside exclusivamente en cada obra.
También aparece en la masa.
En la posibilidad de procesarlas juntas.
Y allí la biblioteca cambia de naturaleza.
Una biblioteca tradicional organiza para recuperar.
Autor.
Título.
Materia.
Editorial.
Clasificación.
Signatura.
Todo el trabajo bibliotecario intenta responder una pregunta aparentemente sencilla:
¿cómo conseguimos que aquello que guardamos pueda ser encontrado?
Pero un corpus destinado a inteligencia artificial introduce otra pregunta:
¿cómo conseguimos que aquello que guardamos pueda ser procesado?
La diferencia parece pequeña.
No lo es.
Un lector busca un libro.
Una máquina puede necesitar millones.
Un lector abre una obra porque quiere conocerla.
Un sistema puede utilizarla como parte de una mezcla gigantesca donde ningún texto individual constituye necesariamente el centro.
El poder no consiste solamente en tener información. Consiste en disponer de infraestructura para procesarla
Entonces empiezan a cambiar las categorías.
Libro.
Archivo.
Dataset.
Token.
Peso.
Modelo.
La obra continúa existiendo.
Pero atraviesa sucesivas transformaciones hasta llegar a un sistema donde ya no podemos señalar fácilmente:
“Esta idea vino exactamente de aquella página.”
El libro entra con nombre y apellido.
El corpus comienza a disolverlo dentro de una multitud.
Aquí aparece una cuestión que solemos olvidar.
Los datos no caen del cielo.
Los corpus tampoco.
Alguien decide.
Qué entra.
Qué no.
Qué idioma.
Qué edición.
Qué género.
Qué época.
Qué tipo de escritura.
Qué calidad.
Qué cantidad.
En el caso Anthropic, la documentación judicial muestra que los ingenieros experimentaban con diferentes conjuntos de libros y analizaban qué combinaciones mejoraban el comportamiento de sus modelos.
Esto es importante porque destruye una ilusión.
La inteligencia artificial no aprende simplemente de algo llamado:
“todo el conocimiento humano”.
Eso no existe como conjunto neutro, completo y perfectamente representativo.
Aprende de colecciones concretas.
Construidas.
Seleccionadas.
Limpiadas.
Filtradas.
Ponderadas.
Con ausencias.
Con excesos.
Con errores.
Con decisiones.
Y, a veces, con historias jurídicas bastante complicadas.
Entonces deberíamos empezar a preguntar algo que cualquier bibliotecario reconocería inmediatamente:
¿Cómo está construida la colección?
Imaginemos otra vez aquella biblioteca.
Pero esta vez conseguimos entrar.
Es una fantasía.
Nadie nos detiene.
Atravesamos una puerta.
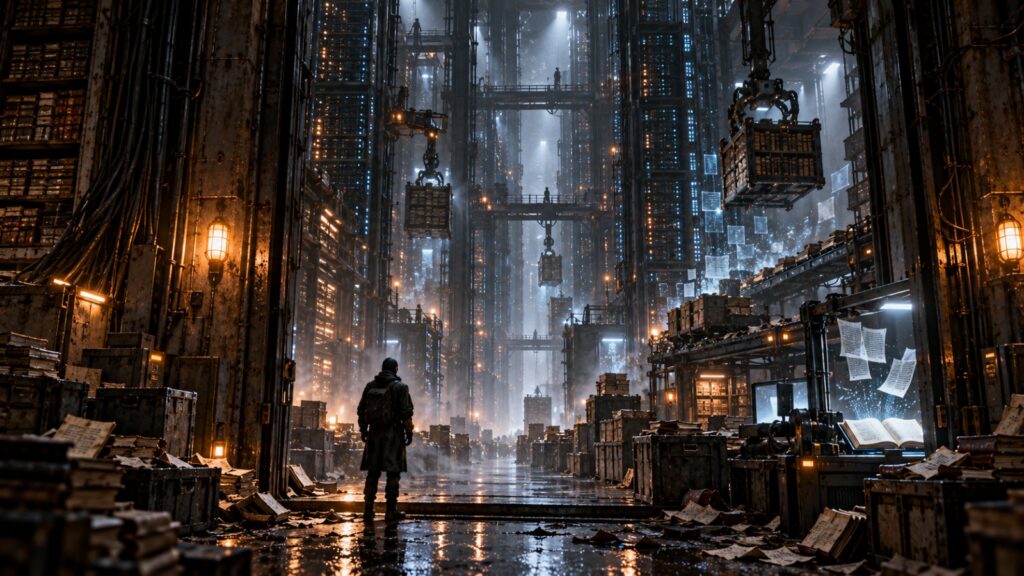
Adentro no hay libros.
Hay un corredor oscuro.
A ambos lados, servidores.
Luces pequeñas.
Ventiladores.
Un zumbido constante.
Caminamos.
Millones de textos están allí.
Pero ninguno puede verse.
Son impulsos.
Archivos.
Copias.
Representaciones.
La inteligencia artificial no aprende simplemente de algo llamado ‘todo el conocimiento humano’ […] Aprende de colecciones concretas
Entonces preguntamos:
—¿Dónde están los libros de historia argentina?
Silencio.
—¿Cuántos autores africanos hay?
Silencio.
—¿Qué proporción está en inglés?
Silencio.
—¿Cuántos libros fueron publicados por grandes editoriales y cuántos por pequeñas editoriales independientes?
Silencio.
—¿Hay publicaciones sindicales?
—¿Bibliotecas populares?
—¿Literatura latinoamericana agotada?
—¿Autores que nunca fueron digitalizados?
Nada.
No porque necesariamente alguien quiera ocultarnos la respuesta.
Simplemente porque nosotros no somos los usuarios de esa infraestructura.
Y ahí está el punto.
Una colección puede ser gigantesca y al mismo tiempo resultar epistemológicamente opaca para la sociedad que ayudó a producir buena parte de aquello que contiene.
Supongamos que pudiéramos construir una inteligencia artificial utilizando todos los libros publicados en Buenos Aires.
Sería impresionante.
Pero si faltaran todos los publicados en Córdoba…
la máquina también aprendería de esa ausencia.
No porque supiera que Córdoba falta.
Justamente lo contrario.
No podría saberlo.
Para ella, el universo disponible sería aquello que recibió.
Esto vale para geografías.
Idiomas.
Clases sociales.
Culturas.
Géneros.
Ideologías.
Tradiciones científicas.
Y formas de conocimiento que quizás nunca llegaron a transformarse en grandes bases digitales.
Por eso una colección no se define solamente por lo que contiene.
También por aquello que excluye.
Las bibliotecas saben esto desde hace mucho.
Toda selección construye una imagen del mundo.
Ninguna biblioteca contiene todo.
Ni siquiera aquella que alguna vez soñó con reunir —según la descripción que aparece en el expediente— algo semejante a “todos los libros del mundo”.
El sueño de totalidad siempre choca contra una pregunta.
¿Quién define qué cuenta como mundo?
Un lector busca un libro. Una máquina puede necesitar millones»
Durante La batalla por la mente habíamos utilizado una fórmula:
Información + Subjetividad + Entorno = Percepción de la realidad.
Ahora podemos trasladar parte de aquella reflexión hacia las máquinas.
No porque una inteligencia artificial tenga subjetividad humana.
No la tiene.
Pero sí posee condiciones de construcción.
Datos.
Arquitectura.
Objetivos.
Procesamiento.
Ajustes.
Evaluaciones.
Contexto.
Todo sistema observa el mundo a través de aquello que consiguió representar.
Y esa representación comienza mucho antes de que alguien escriba una pregunta en una pantalla.
Comienza en la colección.
En aquella biblioteca.
En los libros que entraron.
Y en aquellos que nunca llegaron.
Entonces aparece una conexión inquietante con nuestra saga anterior.
Antes preguntábamos:
¿quién mueve las sombras?
Ahora debemos preguntar:
¿quién elige los materiales con los que la máquina aprenderá a reconocerlas?
Supongamos que dos personas poseen exactamente la misma novela.
Una la guarda en su casa.
La otra dispone además de millones de obras, servidores, científicos, ingenieros, capital y capacidad computacional para procesarlas.
Legalmente ambas pueden ser propietarias de un ejemplar.
Materialmente poseen el mismo objeto.
Pero claramente no poseen la misma capacidad.
Y ahí aparece una diferencia fundamental de nuestra época.
El poder no consiste solamente en tener información.
Consiste en disponer de infraestructura para procesarla.
Durante siglos poseer una biblioteca gigantesca otorgaba prestigio y conocimiento potencial.
Hoy una biblioteca digital gigantesca puede ofrecer algo más.
Capacidad tecnológica.
Por eso quizás la pregunta sobre concentración de conocimiento deba cambiar.
No basta con preguntar:
¿quién tiene los libros?
Tenemos que agregar:
¿Quién posee las máquinas capaces de procesar millones de ellos simultáneamente?
Aquí también debemos evitar nuestra propia trampa.
Sería fácil construir una oposición cómoda:
biblioteca pública buena.
biblioteca corporativa mala.
La realidad no funciona así.
Las bibliotecas públicas también seleccionan.
Tienen presupuestos.
Políticas de adquisición.
Sesgos.
Libros que nunca compraron.
Autores que ignoraron.
Decisiones humanas.
Instituciones públicas pueden censurar.
Pueden excluir.
Pueden abandonar colecciones.
Pueden permitir que el patrimonio se deteriore.
La propiedad pública no garantiza automáticamente pluralidad.
Pero introduce una diferencia política fundamental:
la posibilidad de discutir públicamente su misión.
Podemos exigir presupuesto.
Acceso.
Catálogos.
Políticas de preservación.
Pluralismo.
Responsabilidades.
Una infraestructura privada responde en primer lugar a otra gobernanza.
Sus accionistas.
Sus directivos.
Sus objetivos comerciales.
Sus acuerdos.
Sus regulaciones.
Esto no convierte a la empresa en enemiga.
Pero significa que estamos ante dos formas distintas de organizar memoria y poder.
Y fingir que son equivalentes tampoco sería pensamiento crítico.
La biblioteca que estamos buscando no fue construida para nosotros. No tiene una puerta por donde entre un lector.”
EL DÍA QUE LA MEMORIA CAMBIÓ DE DUEÑO
Quizás esta frase sea demasiado fuerte.
La memoria humana no tiene un único dueño.
Por suerte.
Los libros siguen circulando.
Las bibliotecas siguen existiendo.
Las personas conservan ejemplares.
Los archivos permanecen.
Internet multiplicó copias de una forma que hace casi imposible imaginar una única bóveda controlándolo todo.
Pero algo sí está ocurriendo.
Una parte creciente de nuestra producción cultural está siendo incorporada a infraestructuras privadas cuyo valor depende, precisamente, de su capacidad de procesar cantidades extraordinarias de información.
Y cuando eso sucede, la vieja discusión sobre propiedad cambia.
Porque poseer una colección gigantesca no significa solamente poder leerla.
Puede significar poder convertirla en otra cosa.
Un modelo.
Un servicio.
Una ventaja tecnológica.
Una empresa.
Una infraestructura de conocimiento.
Y entonces aparece una pregunta que todavía no sabemos responder:
¿Qué relación debería existir entre la memoria producida colectivamente y el poder construido privadamente a partir de ella?
Volvamos a nuestra ficción.
Seguimos caminando por aquel corredor imaginario.
Los servidores continúan encendidos.
Llegamos finalmente a una puerta.
Del otro lado se escucha otro ruido.
Ya no es el ventilador de las máquinas.
Es algo diferente.
Como millones de voces hablando muy bajo al mismo tiempo.
Acercamos el oído.
No podemos distinguir palabras.
Una novela.
Un ensayo.
Un libro científico.
Una biografía.
Un poema.
Una investigación.
Todos allí.
Mezclados.
Esperando.
La puerta tiene un pequeño vidrio.
Miramos.
No vemos estanterías.
Vemos números.
Fragmentos.
Matrices.
Representaciones matemáticas.
Algo está ocurriendo con los libros.
Algo que ya no se parece a leerlos.
Preguntamos:
—¿Qué están haciendo?
Nadie responde.
Entonces aparece una palabra en una pantalla.
TOKENIZACIÓN.
Nos quedamos mirando.
En la entrega anterior vimos cómo el libro dejaba de ser papel.
Ahora estamos a punto de verlo perder otra cosa.
Su forma.
El título.
Los capítulos.
Las frases tal como nosotros las conocemos.
Todo comenzará a fragmentarse.
No para destruirlo.
Para que una máquina pueda trabajar con él.
Y quizá allí encontremos la transformación más extraña de toda esta historia.
Un autor pasó meses.
Quizás años.
Buscando una palabra.
Borrando otra.
Moviendo una coma.
Escribiendo un párrafo.
Intentando construir una voz.
El libro llegó completo hasta nosotros.
Pero para entrar en la máquina tendrá que ser desarmado otra vez.
Esta vez no habrá cuchillas.
No habrá papel en el suelo.
No escucharemos ningún ruido.
Será una destrucción mucho más silenciosa.
La obra continuará existiendo.
Pero dentro del sistema…
será otra cosa.
La pantalla se enciende.
Las primeras palabras comienzan a separarse.
Una.
Después otra.
Después un fragmento.
Y otro.
La biblioteca quedó detrás.
Ahora empieza el verdadero procesamiento.
Próxima entrega de La biblioteca de las máquinas
DEL AUTOR AL TOKEN
Qué queda de una obra cuando deja de ser leída como libro y comienza a ser procesada como datos.
Porque quizás el próximo misterio no sea descubrir qué libros entraron en la máquina.
Será comprender algo mucho más difícil:
qué ocurre con una obra cuando la máquina deja de verla como obra.