Qué queda de una obra cuando deja de ser leída como libro y comienza a ser procesada como datos. Por Oscar Rodríguez (Entrega III)
Al pasar del libro impreso al algoritmo, la IA disuelve la autoría y la procedencia de los textos, con el consiguiente peligro: una sociedad que consuma respuestas automáticas sin cuestionar sus fuentes, olvidando la memoria colectiva y poniendo en riesgo el valor de la cultura
LA BIBLIOTECA DE LAS MÁQUINAS
Una saga sobre memoria, cultura, inteligencia artificial y poder
Por Oscar Rodríguez
ENTREGA III
DEL AUTOR AL TOKEN
Qué queda de una obra cuando deja de ser leída como libro y comienza a ser procesada como datos
El libro todavía estaba entero.
Eso es lo primero que debemos recordar.
Había sobrevivido a la cuchilla.
No físicamente.
Eso ya había terminado.
Su tapa había desaparecido.
Su lomo había sido cortado.
Sus páginas habían pasado una por una bajo la luz blanca del escáner.
Después el papel había seguido otro camino.
Pero el libro continuaba allí.
En una pantalla.
Un archivo.
Completo.
Título.
Autor.
Capítulos.
Párrafos.
Puntos.
Comas.
Por unos minutos todavía podía engañarnos.
Todavía parecía un libro.
Entonces alguien ejecutó el proceso.
Y empezó la segunda desaparición.
No hubo ruido.
Eso era lo extraño.
La primera transformación había sido brutal.
Metal.
Cuchillas.
Papel cortado.
Máquinas.
Ésta no.
Ésta ocurrió en silencio.
Una línea de texto apareció en la pantalla.
Después otra.
La máquina comenzó a dividirlas.
No por capítulos.
No por ideas.
No por belleza.
Ni siquiera necesariamente por palabras.
Las separaba según otra lógica.
Una lógica que el escritor nunca había tenido en cuenta.
Porque el escritor escribía para lectores.
Y ahora su libro había llegado a un lugar donde ya no había lectores.
LA PALABRA
Imaginemos que la frase dice:
La casa estaba vacía.
Una persona puede leerla y detenerse.
Casa.
Quizás recuerde una casa.
La de la infancia.
La de la abuela.
Una habitación que alguna vez estuvo llena de voces.
Tal vez imagine una ventana abierta.
Una cortina moviéndose.
Tal vez se pregunte por qué está vacía.
Quién vivía allí.
Qué ocurrió.
Cinco palabras.
Y ya construimos un mundo.
La máquina no hace eso.
No recuerda casas.
No tuvo infancia.
No conoce el olor de una habitación cerrada.
No sabe qué se siente al regresar a un lugar donde antes vivía alguien que murió.
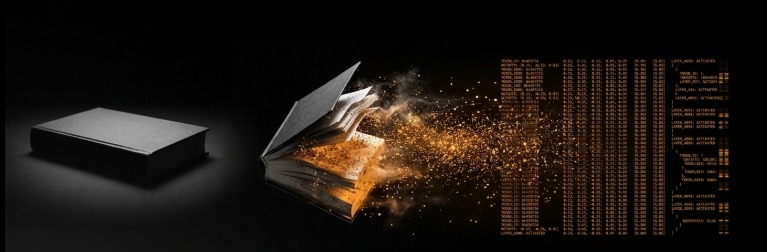
Para trabajar con aquella frase necesita transformarla.
La convierte en unidades.
Tokens.
Y aquí aparece la primera grieta.
Porque un token no es necesariamente una palabra.
Puede ser una palabra.
O una parte.
Un fragmento.
Un signo.
Una secuencia frecuente.
Depende del sistema.
Nosotros vemos:
bibliotecario.
La máquina puede recibir varias piezas.
El lenguaje empieza a desarmarse.
Pero esta vez nadie escucha el sonido.
Una sociedad que pierda la costumbre de buscar fuentes. Que deje de preguntar quién escribió. Cuándo. Dónde. Por qué. Que confunda una respuesta bien redactada con conocimiento
EL HOMBRE QUE ESCRIBIÓ LA PÁGINA
Imaginemos ahora al autor.
No sabemos su nombre.
No importa.
Está sentado frente a una mesa.
Son las tres de la mañana.
Tiene una taza de café frío.
Lleva veinte minutos mirando una frase.
La escribió.
La borró.
Volvió a escribirla.
Cambió un verbo.
Después volvió al primero.
Durante horas intenta encontrar una palabra.
Sólo una.
Finalmente la encuentra.
Sonríe.
Quizás nadie llegue a comprender cuánto le costó.
Años después alguien compra ese libro.
Otro lector subraya justamente aquella frase.
Escribe en el margen:
Esto.
Una sola palabra.
Para el escritor fueron horas.
Para el lector quizá significó una vida.
El libro termina décadas después dentro de una colección digital.
La frase entra en el sistema.
Token.
Token.
Token.
El escritor ya no está en la habitación.
El lector tampoco.
La máquina sigue.
¿DÓNDE FUE EL LIBRO?
Hagamos una pregunta aparentemente sencilla.
Después del entrenamiento…
¿dónde está el libro?
Supongamos que pudiéramos entrar dentro del modelo.
Abrimos una puerta.
Nada.
Buscamos una carpeta con el título.
No está.
Otra con el nombre del autor.
Tampoco.
No existe un pequeño bibliotecario escondido dentro de la inteligencia artificial esperando nuestra pregunta para correr hasta un estante, sacar el volumen y buscar una página.
La imagen es tentadora.
Pero equivocada.
El modelo procesa cantidades enormes de texto.
Aprende regularidades.
Relaciones.
Patrones.
Probabilidades.
Durante el entrenamiento intenta predecir qué token debería seguir a otros.
Se equivoca.
Se ajusta.
Vuelve a intentarlo.
Una vez.
Otra.
Otra.
Millones.
Miles de millones.
Y con cada ajuste algo cambia dentro de una arquitectura matemática demasiado grande para que podamos imaginarla cómodamente.
El libro estuvo allí.
Participó.
Pero ahora está mezclado con otros.
Miles.
Millones.
La pregunta vuelve.
—¿Dónde está?
Y por primera vez nadie puede señalar una estantería.
NO DESAPARECIÓ
Aquí debemos tener cuidado.
Es fácil convertir lo desconocido en magia.
O en monstruo.
La inteligencia artificial no es una criatura sobrenatural.
Un modelo no absorbe almas de escritores.
Tampoco tenemos dentro de una computadora todos los libros guardados exactamente como estaban, esperando secretamente ser recuperados.
Eso sería una simplificación.
Pero decir que solamente “aprende patrones” tampoco resuelve todo.
Porque sabemos algo más.
Los modelos pueden memorizar.
En determinadas condiciones pueden reproducir fragmentos vistos durante el entrenamiento.
La repetición de ciertos textos, el tamaño del modelo y otros factores pueden aumentar esa capacidad.
Entonces entramos en una zona difícil.
Aprender.
Generalizar.
Memorizar.
Tres palabras que parecen perfectamente separadas cuando las escribimos.
Dentro de una máquina, las fronteras pueden volverse menos tranquilizadoras.
Aquello que nació como obra individual contribuye a una capacidad colectiva del sistema. Y entonces ocurre algo extraño. El libro tenía autor. La respuesta de la máquina… ¿lo tiene?
LA PRIMERA VOZ
Imaginemos que alguien abre el sistema meses después.
Escribe:
—Contame una historia.
La máquina comienza.
Una frase.
Después otra.
La historia nunca existió exactamente así.
Nadie la había escrito.
Y sin embargo hay algo familiar.
La construcción.
El ritmo.
Una metáfora.
Cierta forma de describir la noche.
¿De dónde salió?
Quizás de ninguna obra en particular.
Quizás de regularidades aprendidas entre millones de textos.
Quizás alguna estructura apareció tantas veces que terminó formando parte de la capacidad del modelo.
Quizás determinados fragmentos fueron memorizados.
No podemos saberlo simplemente mirando la respuesta.
Y ahí aparece el verdadero misterio de esta entrega.
No es que la máquina haya robado secretamente una frase.
Eso puede investigarse.
El problema más profundo es otro.
Puede resultar extremadamente difícil reconstruir todos los antepasados de una respuesta.
LA BIBLIOTECA SABÍA HACER ESO
Durante siglos desarrollamos una obsesión.
La procedencia.
Un investigador escribe una afirmación.
Después coloca una referencia.
Otro puede buscarla.
Llegar al documento.
Comprobar.
Discutir.
Decir:
—No. Esta interpretación es incorrecta.
La ciencia construyó buena parte de su autoridad sobre esa posibilidad.
El periodismo también.
Las bibliotecas hicieron algo parecido.
Autor.
Título.
Editorial.
Edición.
Fecha.
Clasificación.
El catálogo es, entre otras cosas, un mapa para regresar.
No solamente dice:
esto existe.
Dice:
podés encontrarlo acá.
Pero ahora la máquina produce una respuesta.
Leemos.
Parece correcta.
Preguntamos:
—¿De dónde salió?
Y algo empieza a fallar.
Puede darnos referencias.
Algunas pueden ser correctas.
Otras pueden no serlo.
Porque el modelo no necesariamente recorrió conscientemente una bibliografía para construir cada frase.
La capacidad estaba distribuida.
La respuesta emerge.
Y nosotros tenemos que comenzar el camino inverso.
Verificar.
Buscar.
Reconstruir.
La máquina produce.
Nosotros debemos recuperar la procedencia.
El modelo procesa cantidades enormes de texto. Aprende regularidades. Relaciones. Patrones. Probabilidades
EL AUTOR DESAPARECE
El título continúa existiendo.
El autor también.
Sus libros siguen en bibliotecas.
Nada de esto los borra físicamente del mundo.
Pero dentro del proceso ocurre algo mucho más sutil.
El autor deja de ser el centro.
Su libro entra junto a millones.
Su sintaxis.
Sus palabras.
Sus decisiones.
Sus conocimientos.
Todo comienza a participar dentro de relaciones mayores.
Aquello que nació como obra individual contribuye a una capacidad colectiva del sistema.
Y entonces ocurre algo extraño.
El libro tenía autor.
La respuesta de la máquina…
¿lo tiene?
Podemos decir que fue generada por un modelo.
Pero el modelo fue entrenado por una empresa.
Construido por investigadores.
Alimentado con textos producidos por millones de personas.
Programado mediante herramientas creadas por otras.
Ejecutado sobre hardware construido por otras más.
La frase que aparece frente a nosotros parece tener un origen.
Pero si tiramos del hilo…
aparecen millones de manos.
UNA HABITACIÓN LLENA DE VOCES
Imaginemos una habitación.
Es enorme.
Muchísimo más grande que cualquier biblioteca.
Dentro hay un millón de escritores.
Algunos murieron hace siglos.
Otros están vivos.
Hay poetas.
Historiadores.
Periodistas.
Novelistas.
Científicos.
Programadores.
Filósofos.
Traductores.
Todos hablan.
Al mismo tiempo.
Primero escuchamos un estruendo.
Después descubrimos patrones.
Frases que se repiten.
Formas.
Relaciones.
Estructuras.
Conceptos que atraviesan siglos.
Ahora imaginemos una máquina escuchándolo todo.
No entiende como nosotros.
No ama.
No odia.
No recuerda su infancia.
Pero detecta regularidades.
Aprende algo de aquella multitud.
Después abrimos la puerta.
Todos los escritores desaparecen.
La máquina queda sola.
Nos acercamos.
Preguntamos:
—¿Qué sabés?
Y empieza a hablar.
Reconocemos nuestro idioma.
Nuestra historia.
Nuestros géneros.
Nuestras maneras de explicar.
Parte de nuestro conocimiento.
Pero las voces individuales se han vuelto difíciles de separar.
Entonces comprendemos algo que quizás deberíamos haber visto desde el comienzo.
El problema no era solamente qué libros entraban.
Era qué sucedía cuando millones de obras dejaban de estar separadas.
Para trabajar con aquella frase [la máquina] necesita transformarla. La convierte en unidades. Tokens. Y aquí aparece la primera grieta
EL TOKEN ERA LA PUERTA
Parecía una pieza técnica.
Casi irrelevante.
Algo para informáticos.
Pero el token marca una frontera simbólica.
De un lado hay una obra.
Del otro empieza una representación procesable.
Antes preguntábamos:
¿Qué quiso decir el escritor?
Después empieza a importar otra pregunta:
¿Qué regularidades puede extraer el sistema?
Y en ese cambio se transforma también el valor del libro.
Porque una novela puede valer veinte dólares en una librería.
Pero millones de libros procesados conjuntamente pueden contribuir a construir una tecnología valuada en miles de millones.
El valor ya no está solamente en cada ejemplar.
Está en la posibilidad de procesar la multitud.
Y ahí deja de ser una discusión puramente tecnológica.
Entra la economía.
La cultura.
El derecho.
El poder.
ALGUIEN APAGA LA LUZ
Volvamos al autor.
Terminó aquella frase.
Son casi las cuatro de la mañana.
Cierra la computadora.
Se levanta.
Apaga la luz.
Nunca sabrá qué ocurrirá con esas palabras treinta años después.
No puede imaginar la máquina.
No puede imaginar los centros de datos.
No puede imaginar que su libro será convertido en pequeñas unidades matemáticas.
No puede imaginar que determinadas regularidades de su escritura podrían terminar participando en la formación de una capacidad que una empresa ofrecerá a millones de personas.
Para él es más sencillo.
Escribió un libro.
Eso es todo.
O eso cree.
MUCHOS AÑOS DESPUÉS
Una persona abre una computadora.
No conoce al escritor.
Nunca compró su libro.
Quizás ni siquiera escuchó su nombre.
Escribe una pregunta.
La máquina responde.
La persona lee.
Algo de aquella respuesta existe porque millones de seres humanos escribieron antes.
No sabemos cuánto corresponde a uno.
Cuánto a otro.
Cuánto emerge de combinaciones estadísticas.
Cuánto se generalizó.
Cuánto pudo haberse memorizado.
Lo que sabemos es que la máquina no apareció de la nada.
Tiene antepasados.
Sólo que ya no puede presentarlos a todos.
Y eso debería inquietarnos más que cualquier historia de una computadora consciente.
Porque la máquina no necesita despertarse.
No necesita odiarnos.
No necesita conspirar.
Sólo necesita volverse útil.
Lo suficiente para que empecemos a confiar.
Lo suficiente para que dejemos de preguntar.
Lo suficiente para que un día aceptemos una respuesta sin intentar averiguar de dónde salió.
El autor escribía para lectores. Y ahora su libro había llegado a un lugar donde ya no había lectores.
EL VERDADERO PELIGRO
Quizás no sea una inteligencia artificial que mienta.
Siempre podremos intentar detectar una mentira.
Puede existir algo más profundo.
Una sociedad que pierda la costumbre de buscar fuentes.
Que deje de preguntar quién escribió.
Cuándo.
Dónde.
Por qué.
Que confunda una respuesta bien redactada con conocimiento.
Que olvide que detrás de cada afirmación existe una historia.
Entonces el problema ya no estaría dentro de la máquina.
Estaría en nosotros.
Porque una sociedad que no necesita procedencia…
tampoco necesita bibliotecas.
Ni archivos.
Ni investigadores.
Ni periodistas.
Solamente necesita respuestas.
Y eso sería muchísimo más peligroso.
La pantalla queda encendida.
En ella hay una frase.
Parece verdadera.
Perfecta.
Bien escrita.
Nadie en la habitación sabe quién fue el primero en formular la idea.
Quizás alguna vez estuvo en uno de aquellos millones de libros.
Quizás fue una combinación nueva.
Quizás sea equivocada.
Durante algunos segundos nadie habla.
Después una persona pregunta:
—¿Quién dijo esto?
La máquina responde.
Pero ya no estamos seguros de que la pregunta correcta sea ésa.
Porque el libro tenía propietario.
El texto tenía autor.
La edición tenía editorial.
La biblioteca tenía catálogo.
Ahora tenemos otra cosa.
Una capacidad.
Una máquina que aprendió a producir lenguaje después de procesar una parte gigantesca de nuestra cultura.
Y entonces aparece la pregunta que nadie consigue apagar.
No importa cuántas veces cerremos la pantalla.
Vuelve.
Como un ruido detrás de una pared.
Como pasos en una habitación donde sabemos que no debería haber nadie.
Si una capacidad tecnológica fue construida con millones de fragmentos de nuestra memoria colectiva…
¿a quién pertenece realmente esa capacidad?
El cursor queda titilando.
Una vez.
Otra.
Otra.
Nadie escribe nada.
Todavía.
Próxima entrega de La biblioteca de las máquinas
¿DE QUIÉN ES LA MEMORIA?
Cuando siglos de cultura producida colectivamente se convierten en capacidad tecnológica privada.
Hasta ahora seguimos a los libros.
En la próxima entrega tendremos que seguir el dinero.
Y quizás descubramos que la pregunta nunca fue solamente qué aprendieron las máquinas.
Sino algo mucho más antiguo.
Quién consigue apropiarse del valor de aquello que aprendimos entre todos.